Iscriviti alla newsletter
Inserisci la tua email e iscriviti alla nostra newsletter
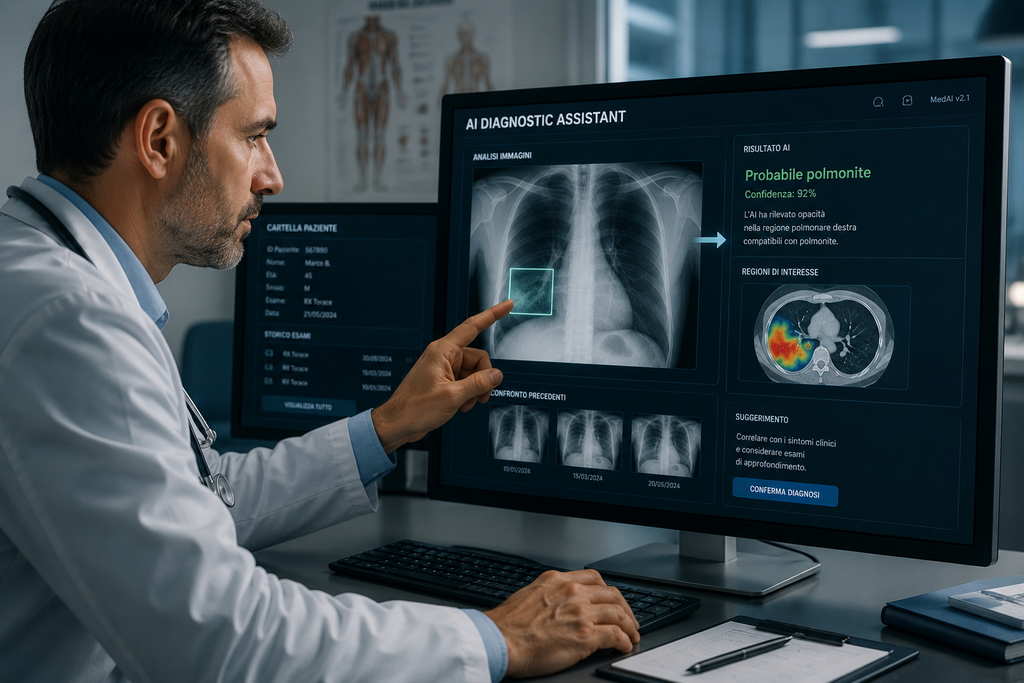
Le ultime selezioni per medici generici e specialisti in medicina interna e pediatria sono state effettuate in avenida de la Revolución, a fine luglio. Oltre alle specifiche competenze mediche, si richiedevano abilità informatiche, gestione delle patologie in accordo con il profilo epidemiologico del Paese, conoscenza della medicina familiare e della salute comunitaria. La ricerca era finalizzata a rafforzare un sistema di telemedicina denominato DoctorSV. Un sistema innovativo perché supportato dall’intelligenza artificiale (IA o AI, nell’acronimo inglese).
Scaricata l’applicazione sul cellulare ed effettuata la registrazione, l’utente può parlare in videochiamata con un medico. Questi, anche con l’aiuto dell’IA, formulerà una diagnosi e preparerà una ricetta digitale che la persona esibirà in una delle farmacie convenzionate. Tutto gratuitamente.
DoctorSV è in essere dal 15 novembre 2025 a El Salvador, il piccolo Paese centro americano noto per il suo presidente autocrate ammaliato dalla tecnologia, Nayib Bukele.
Stando ai dati del Governo, nei primi sei mesi di attività gli utenti sono arrivati a un 1,5 milioni (su una popolazione totale di 6,5 milioni).
La piattaforma salvadoregna è stata creata con il supporto tecnologico di Google (Google Cloud più Gemini AI).
Anche la concorrente OpenAI si è buttata sulla salute creando ChatGPT Health: «Per aiutare – si legge nella presentazione – a sentirsi più informati, preparati e sicuri nella gestione della propria salute. […] oltre 230 milioni di persone in tutto il mondo pongono domande su salute e benessere su ChatGPT ogni settimana».
È bene ricordare che OpenAI era nata (nel 2015) come organizzazione non profit. Oggi è una società «for profit», anche se mantiene – probabilmente per salvare le apparenze – uno spicchio di essa per portare benefici alla collettività (Public benefit corporation, Pbc).
Dall’assistenza medica al giornalismo, da El Salvador all’Italia. Qui, il Foglio, quotidiano di nicchia che gode di un certo prestigio, dal 18 marzo 2025 esce ogni martedì in un’edizione interamente scritta dall’intelligenza artificiale.
A mo’ di esempio, riportiamo un passaggio dell’IA sul tema della «fine della lettura»: «Si leggono meno libri, si reggono con più fatica testi lunghi, gli studenti sopportano sempre meno la complessità, i video brevi allenano il cervello alla ricompensa immediata e l’IA promette di eliminare persino la fatica della scrittura». È una riflessione (se possiamo usare questo termine per un algoritmo) plausibile e ben scritta.
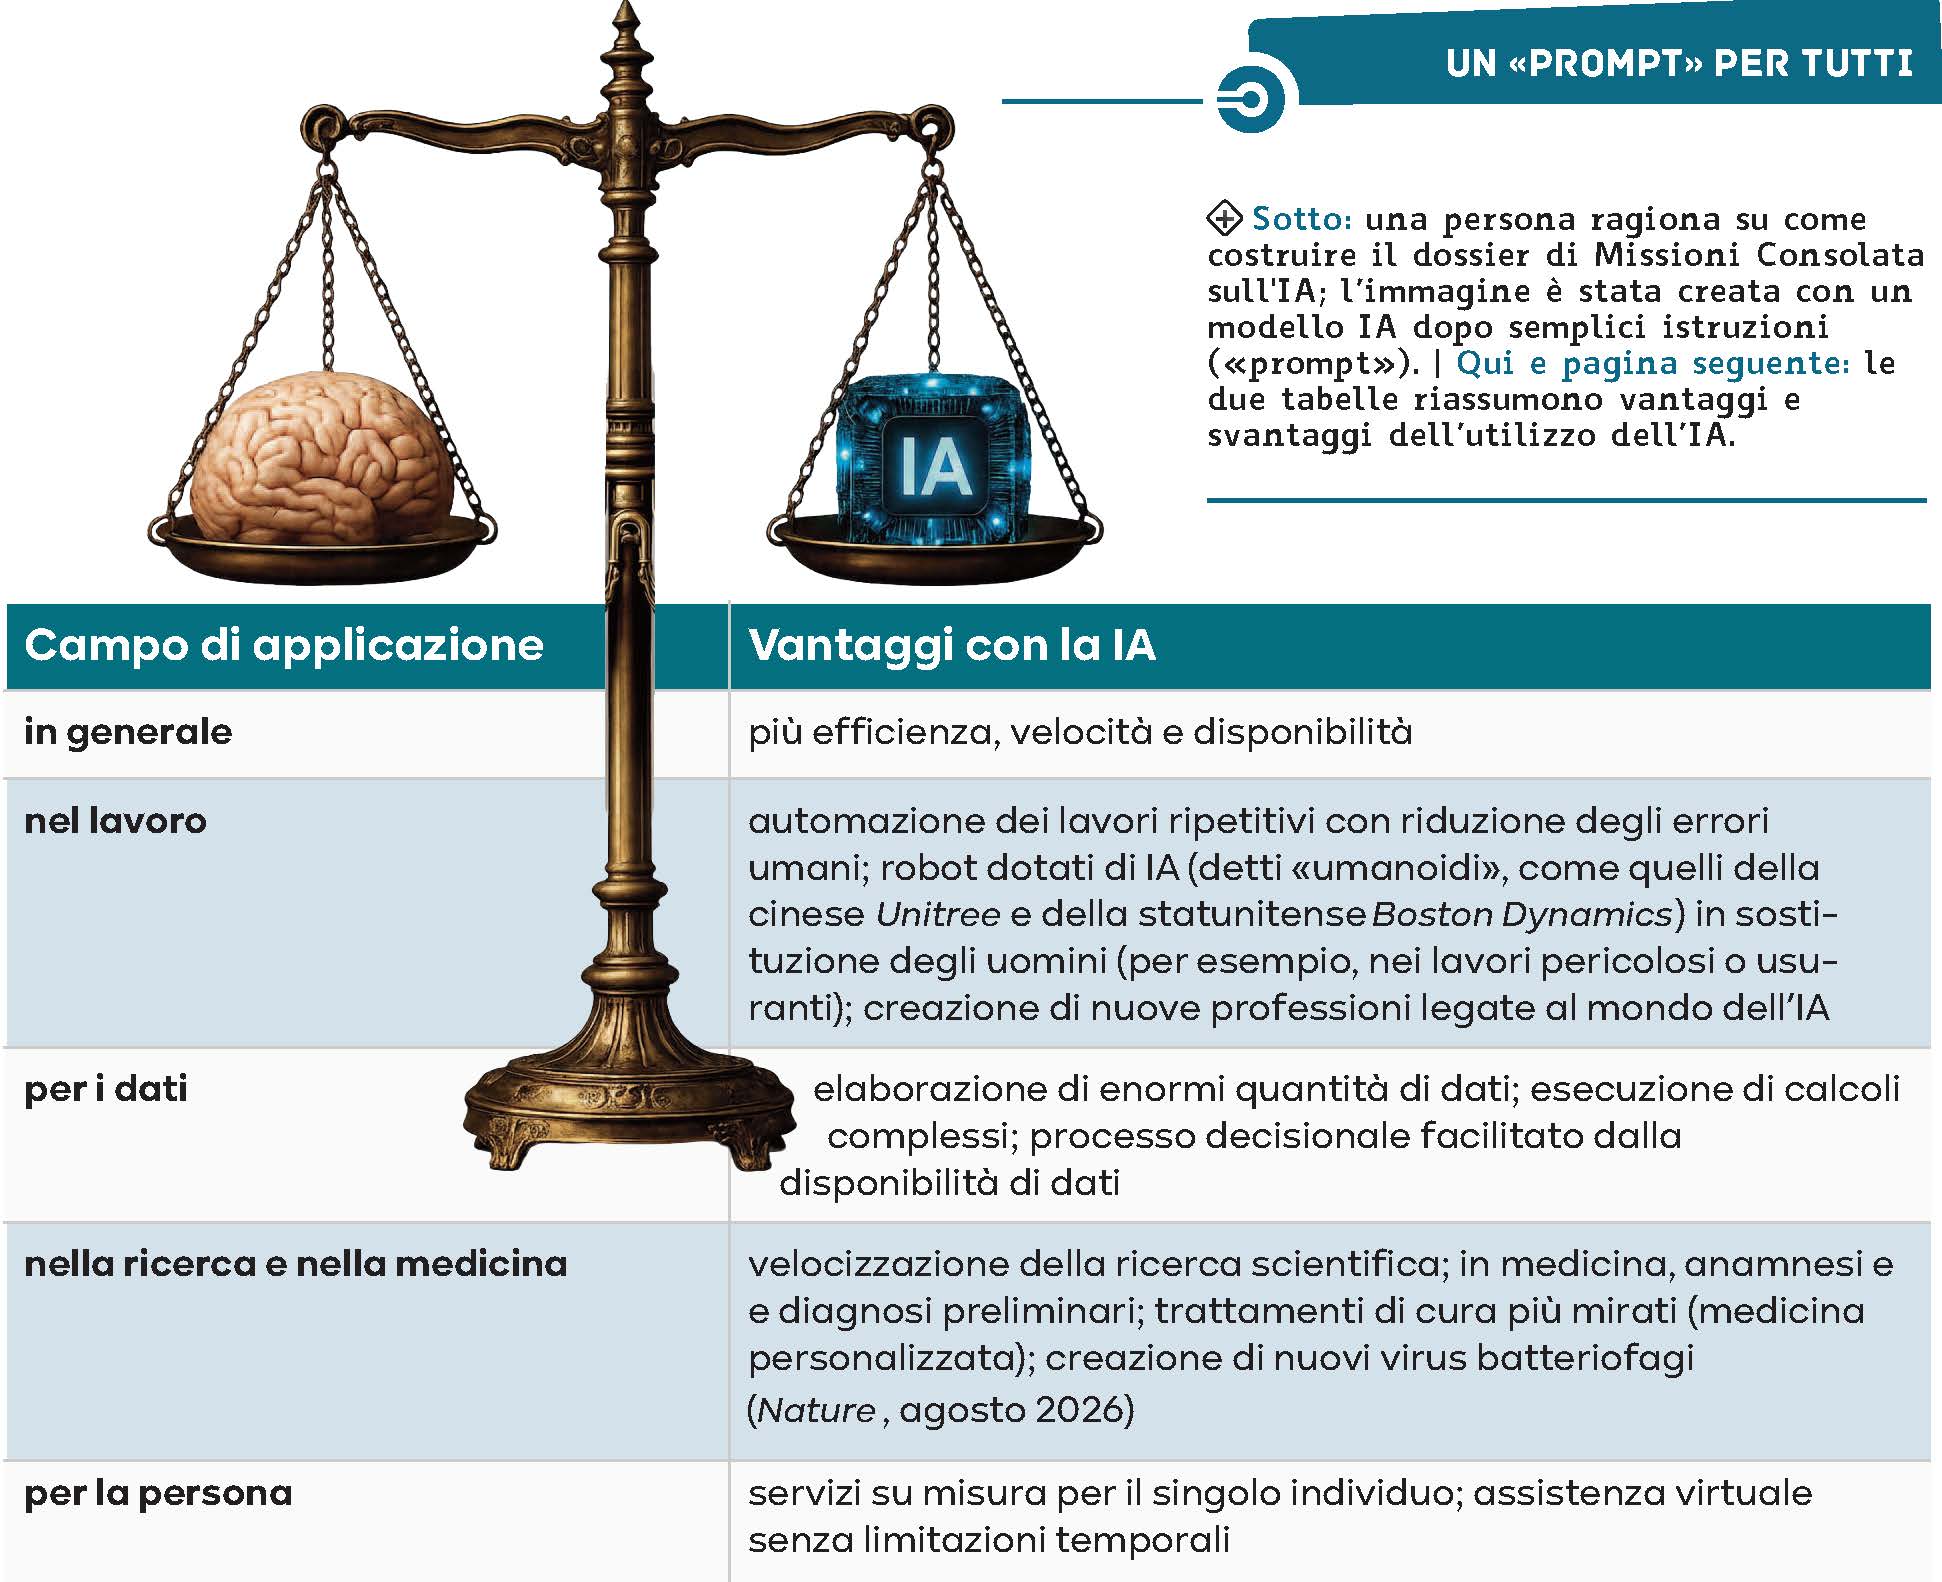
Anche noi, nel nostro piccolo, abbiamo utilizzato l’IA: tutte le foto di questo dossier sono state create con essa partendo da alcuni semplici «prompt», le istruzioni di partenza fornite da chi scrive. Basteranno i prompt per mantenere il controllo sul prodotto e il posto di lavoro? Al momento sì, in futuro chissà.
La rivoluzione dell’IA non soltanto è in corso, ma è anche rapidissima. Che sia «buona» o «cattiva» dipenderà dall’uomo e dalla sua volontà.
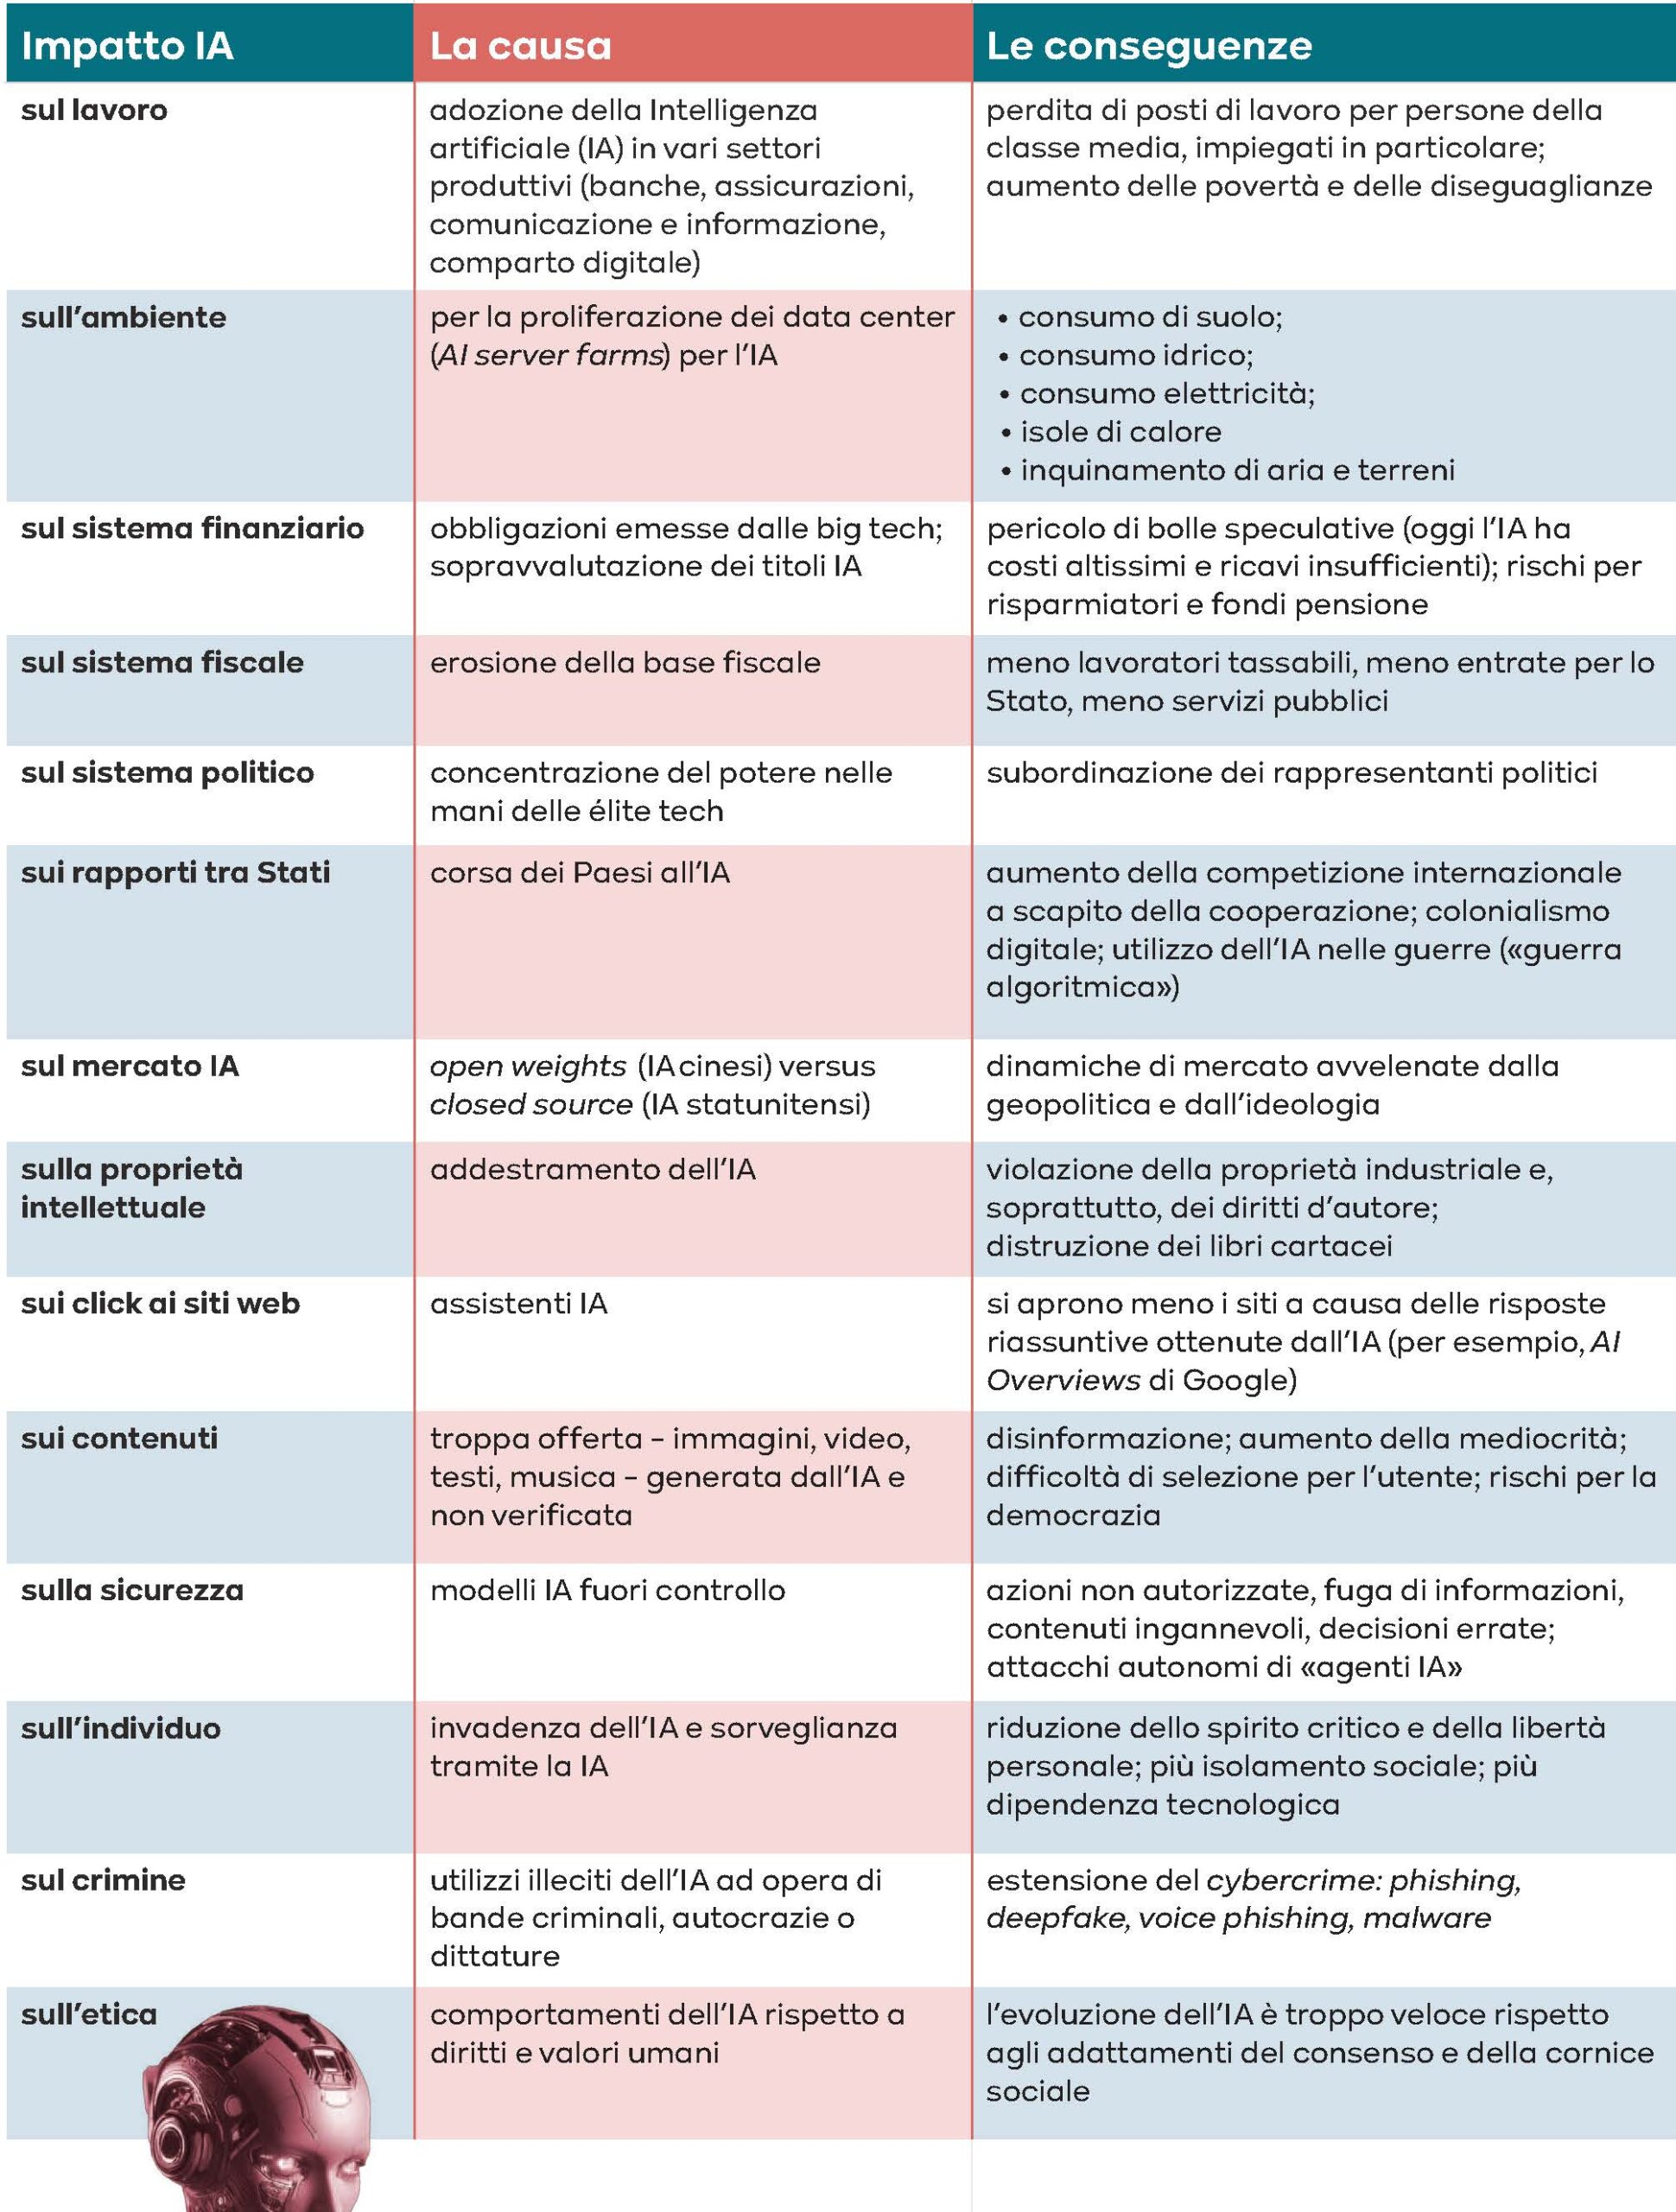
Nelle due tabelle riportate in queste pagine abbiamo provato a elencare vantaggi e svantaggi dell’IA. La discussione tra tecnolatrici e tecnofobici non è inutile se aiuta ad arrivare a una sintesi che tenga conto del maggior numero possibile di variabili. La variabile ambientale è una delle più rilevanti, pur in un periodo storico in cui clima e ambiente non sono (purtroppo) una priorità della politica. L’Agenzia internazionale per l’energia (Iea) ha calcolato che la principale fonte di elettricità per i data center viene dal carbone (30 per cento, con Cina e Stati Uniti in testa), mentre la produzione di energia da risorse rinnovabili è ferma al 27 per cento.
È evidente che un intervento dello Stato e/o delle organizzazioni internazionali (Ue, Onu, ecc.) è fondamentale per stabilire delle regole basilari e non lasciare totale libertà al mercato (che sappiamo capace di molti danni).
Per il momento, a parte il caso dell’Unione europea (la più avanzata nella regolamentazione), i tentativi per regolamentarla appaiono dettati da mera convenienza geopolitica (la Pax silica degli Usa versus la World AI cooperation organization a guida cinese). Detto questo, nell’attuale caos mondiale, fare previsioni sull’oggi e sul domani dell’IA rimane un azzardo totale. Su questo punto troviamo consenziente anche il chatbot – così vengono chiamati gli assistenti virtuali – di ChatGPT. Al prompt «Cosa prevedi per il futuro dell’IA?», il sistema risponde esordendo così:«È difficile fare previsioni precise».
Paolo Moiola
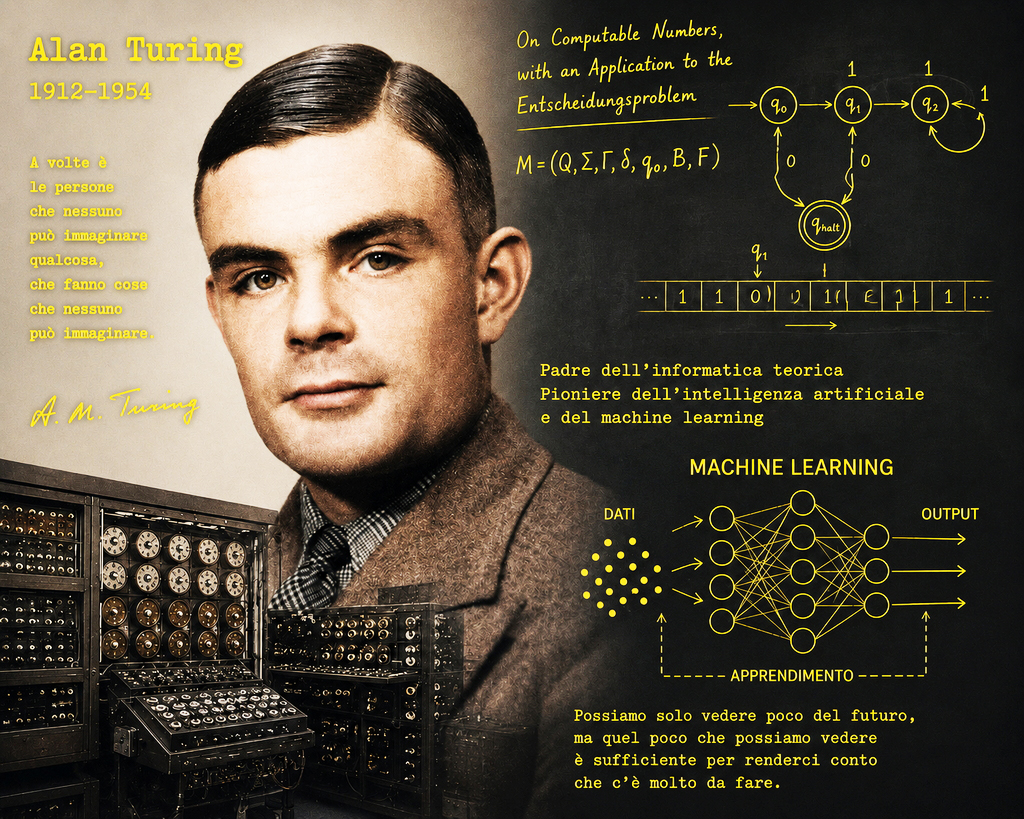
Che cosa sia esattamente l’intelligenza artificiale, e quanto sia davvero intelligente, è una questione più spinosa di quanto sembri, e per ragioni tutt’altro che tecnologiche: il problema è che non esiste, a tutt’oggi, una definizione ampiamente condivisa di che cosa sia l’intelligenza tout court. Se ne accorse già il matematico inglese Alan Turing nel 1950: invece di provare a definire che cosa significasse «pensare», propose un test comportamentale, il celebre «gioco dell’imitazione».
Per buona parte della sua storia, l’intelligenza artificiale ha risolto il problema semplicemente scegliendo una delle possibili risposte e ignorando le altre: intelligenza equivale a ragionamento logico. Per decenni si è provato a costruire macchine «intelligenti» componendo enormi cataloghi di istruzioni puntuali, una sorta di ricettario sterminato in cui si tentava di racchiudere ogni possibile eventualità. Funzionavano, entro confini molto ristretti, per esempio nel gioco degli scacchi. Bastava, però, spostarsi anche di poco dal compito per cui erano state programmate perché quelle stesse macchine andassero in crisi: si mostravano adeguate a un’unica attività, incapaci di fare altro.
La svolta giunse quando si abbandonò l’idea di scrivere delle regole a tavolino e si scelse, come riferimento, qualcosa di molto più umile e familiare: il modo in cui impara un bambino.
Nessuno consegna a un neonato un manuale con la definizione di «cane»: il bambino ne vede tanti, in contesti diversi, e costruisce da solo, per esperienza ripetuta, un modello mentale flessibile che gli permetta poi di riconoscere un cane.
È esattamente questo il principio su cui si fonda l’apprendimento automatico, il cosiddetto machine learning: invece di dettare regole, si mostrano alla macchina quantità enormi di esempi, lasciando che sia questa, correggendo pian piano milioni di parametri interni, a costruirsi un proprio modello del mondo. Un cambio di paradigma, prima ancora che un progresso tecnico.
Forme di intelligenza artificiale costruite su questo principio esistono già da diversi anni, e le abbiamo incontrate innumerevoli volte senza saperlo: i sistemi di raccomandazione che ci sugge-
riscono il prossimo film da vedere, i filtri che separano lo spam dalla posta, i traduttori online in tempo reale. Modelli predittivi fondati sullo stesso approccio governano già il traffico delle nostre città e affiancano la diagnostica sanitaria attraverso dispositivi indossabili.
Quello che ha davvero cambiato la percezione collettiva è stato però il passaggio dall’intelligenza artificiale «predittiva» a quella «generativa». Non tanto, o non solo, per la sua potenza tecnica, quanto perché per la prima volta il suo comportamento ci è sembrato assomigliare a qualcosa di intimamente umano: ragionare, argomentare, scrivere, conversare. Nel novembre 2022, il lancio pubblico di ChatGPT ha permesso a questa tecnologia di uscire dai laboratori e di porsi alla portata di chiunque.
Potremmo chiederci se davvero l’intelligenza artificiale, così performante dal punto di vista del linguaggio, ragioni come un essere umano. Meccanicamente, un modello linguistico ha imparato a fare una cosa sola, in modo estremamente sofisticato: prevedere quale sarà la parola successiva in una sequenza, sulla base di innumerevoli esempi di testo umano. È lo stesso principio di funzionamento, su scala molto più vasta, del correttore automatico, che ci suggerisce la parola seguente mentre stiamo scrivendo un messaggio.
Proprio da qui nasce una delle metafore più fortunate: quella del «pappagallo stocastico», ovvero un sistema che ricombina, con sofisticazione statistica, frammenti di testo senza alcun legame. L’intelligenza artificiale non ha occhi, non ha corpo, non ha mai provato gioia o paura. Quando scrive che «il tramonto era commovente», non sta provando nulla: sta generando la sequenza di parole più probabile in quel contesto, perché in miliardi di testi umani frasi simili comparivano vicino alla parola «tramonto».
Quella del «pappagallo stocastico» è un’immagine efficace, ma non racconta tutta la storia. Le ricerche più recenti hanno cominciato a rilevare, all’interno dei modelli IA, qualcosa di assai più complesso di un semplice copia-incolla statistico. Insomma, a un occhio attento che scruti l’interno di un modello IA, si rivela una vera e propria struttura concettuale, non una ripetizione meccanica. Del resto, nessuno direbbe che il cervello umano non sia intelligente solo perché ogni singolo neurone non fa altro che trasmettere un impulso al neurone successivo: le proprietà di un sistema vanno cercate al livello della sua complessità d’insieme, non in quello dei suoi singoli passaggi.
Restano, però, differenze reali. La più citata riguarda l’esperienza: un essere umano impara a conoscere il mondo anche attraverso il corpo, i sensi, il contatto fisico, mentre un’intelligenza artificiale addestrata solo su testo non ha mai visto né toccato nulla di ciò di cui scrive. È un’obiezione seria, ma vale la pena ricordare che anche un essere umano parla con cognizione di causa di luoghi mai visitati, basandosi solo su libri o fotografie; e che la direzione in cui si muove la ricerca sta già assottigliando questo divario: i modelli multimodali, capaci di elaborare immagini e suoni, e i primi esperimenti di integrazione tra intelligenza artificiale e robotica lasciano immaginare che, in un futuro non troppo lontano, queste macchine potranno disporre di qualcosa che assomiglia molto da vicino ai nostri sensi familiari.
Non regge poi così bene neppure la critica di chi, per ridimensionare il ruolo degli strumenti IA, insiste sul fatto che sbaglino spesso (le cosiddette «allucinazioni») e siano condizionati da numerosi pregiudizi: a ben vedere, è un’osservazione che finisce per spingere proprio nella direzione opposta a quella voluta, perché descrive un’attitudine spiccatamente umana.
Se abbiamo compreso che genere di intelligenza abbiamo di fronte, resta una domanda: su che cosa ha imparato a pensare? Ha imparato su di noi. I grandi modelli linguistici si sono formati su una quantità di testi che sfida l’immaginazione – centinaia di miliardi di parole – attinta da fonti di natura molto diversa tra loro. Il web ha fornito la massa: miliardi di pagine raccolte e indicizzate da archivi pubblici come Common Crawl. I social media e i forum vi hanno aggiunto il linguaggio quotidiano, l’ironia, il dibattito informale, il registro colloquiale che nessun manuale avrebbe potuto insegnare. Wikipedia, con i suoi sessanta milioni di voci in trecento lingue, scritte interamente da volontari, ha dato struttura e precisione enciclopedica. Le biblioteche digitali di opere in pubblico dominio hanno fornito la spina dorsale letteraria e narrativa. Il codice sorgente condiviso dai programmatori di tutto il mondo ha insegnato il ragionamento formale e la logica procedurale.
Nessuno degli autori di tutto questo materiale ha firmato un contratto né ricevuto un compenso: hanno semplicemente partecipato alla vita ordinaria della rete, senza sapere che quella partecipazione sarebbe diventata, un giorno, la materia prima di un’industria miliardaria.
Il contributo delle aziende che oggi dominano il settore non va certo sminuito: esse hanno fornito capitali, potenza di calcolo, ingegneria. Resta però un’asimmetria difficile da ignorare: le fondamenta sono state costruite collettivamente, mentre i profitti restano privati. Se l’intelligenza artificiale è stata edificata su un bene comune, è lecito chiedersi se non si debba restituire qualcosa alla collettività.
C’è anche un sequel inquietante in questa straordinaria avventura collettiva. Quando i primi grandi modelli linguistici furono addestrati, tra il 2018 e il 2022, internet era ancora, in stragrande maggioranza, un prodotto umano: milioni di stili, di lingue, di registri, di prospettive, la diversità imprevedibile di miliardi di persone che scrivevano senza sapere di stare costruendo un dataset. Oggi quella proporzione si è capovolta a una velocità che ha sorpreso gli stessi addetti ai lavori. Un’indagine della società Graphite su un vasto campione di articoli in lingua inglese ha rilevato che la quota di contenuti generati dall’IA, praticamente nulla prima del 2022, ha superato il 50% già alla fine del 2024. Il fenomeno non si limita al web: secondo un recente studio del National bureau of economic research (Nber), oltre il 60% dei nuovi titoli è ormai interamente generato dall’intelligenza artificiale.
Il problema che ne deriva va ben oltre la qualità dei singoli testi pubblicati. Se i modelli futuri verranno addestrati anche sull’output dei modelli attuali – ed è ormai pressoché inevitabile – che cosa succederà alla loro capacità di rappresentare fedelmente il mondo? La prima conseguenza, la più immediata, è che smetteranno di farlo.
Nel settembre 2024, la ricercatrice Robyn Speer ha chiuso wordfreq, un progetto open source che analizzava la frequenza delle parole in oltre quaranta lingue attingendo al web, ai social media, ai libri. La ragione era che l’intelligenza artificiale generativa ha inquinato i dati. Non è più possibile, insomma, distinguere la voce umana dal suo riflesso sintetico.
Alla perdita di aderenza alla realtà si affianca un secondo rischio, più strutturale. Uno studio pubblicato su Nature nel 2024 ha dimostrato che l’uso indiscriminato di contenuti generati da altri modelli nell’addestramento produce difetti irreversibili, facendo scomparire tutto ciò che non è distribuito uniformemente: i casi rari, gli stili minoritari, le formulazioni insolite. Alcuni ricercatori paragonano questo fenomeno all’endogamia genetica: una popolazione che si riproduce solo al proprio interno perde diversità, si indebolisce, si avvita su se stessa. Il risultato è una deriva silenziosa verso testi sempre più corretti e fluidi, ma anche sempre più piatti, prevedibili, intercambiabili.
A rendere il quadro ancora più urgente c’è la circostanza che, mentre la rete si riempie di contenuto sintetico, i modelli hanno bisogno di quantità sempre maggiori di dati di buona qualità per continuare a progredire. Secondo le stime dell’istituto di ricerca Epoch, il serbatoio di testi umani di alta qualità disponibili sul web potrebbe esaurirsi nel giro di pochi anni. L’intelligenza artificiale si trova così stretta tra due pressioni convergenti: da un lato la materia prima autentica scarseggia, dall’altro quella sintetica la contamina, impoverendola inesorabilmente.
Il collasso dei dati non sarà causato, come si potrebbe pensare, da un problema tecnico, bensì dal modo in cui gli esseri umani stanno scegliendo di servirsi degli strumenti IA. Proviamo a chiarirlo con un semplice esempio. Un candidato scrive il proprio curriculum con l’aiuto dell’IA. Il documento viene ricevuto da un sistema automatico di selezione del personale, anch’esso basato sull’IA, che produce una shortlist. Quest’ultima viene scorsa distrattamente da un responsabile delle risorse umane, che userà a sua volta uno strumento IA per effettuare la selezione. In questo circuito nessuna esperienza reale entra mai davvero in gioco: nessuno legge, nessuno valuta, nessuno decide sulla base di un incontro autentico. Il testo prodotto da un modello viene giudicato da un altro modello, genera una decisione mediata da un terzo, e l’intero ciclo si avvita su se stesso, senza mai produrre informazione nuova. Non è un caso estremo, né futuribile: è già ordinario in molti settori. Lo si potrebbe definire «utilizzo dell’IA come protesi»: uno strumento che fa qualcosa al posto nostro. Esiste però un altro modo di impiegare la stessa tecnologia, che si potrebbe definire come «strumento di esplorazione»: applicare l’IA a situazioni che non erano mai state osservate prima – per esempio, dare forma a saperi che esistevano solo in forma orale o dispersa – e rendere pubblici i risultati. In questo secondo caso, l’esperienza umana non esce dal circuito. È questo tipo di utilizzo che meriterebbe di essere incentivato, perché è l’unico capace di nutrire la diversità invece di eroderla. Un’immagine presa in prestito dall’ecologia aiuta a comprendere. Un ecosistema è robusto quando è diverso: una foresta a specie unica cresce più in fretta, ma basta un parassita per abbatterla; una foresta mista cresce più lentamente, ma resiste. Un corpus di dati funziona allo stesso modo. Le comunità che parlano lingue minoritarie, che coltivano secondo pratiche non industriali, che custodiscono conoscenze mai passate per la scrittura, non sono una curiosità da includere per completezza: sono, in senso proprio, il tipo di esperienza di cui un ecosistema digitale ha bisogno per restare vivo.
Le forze del mercato che spingono verso l’automazione dei passaggi umani – produrre di più, più in fretta, con meno persone – sono strutturali, e non si contrastano con la buona volontà di singoli utenti illuminati. Servono incentivi (normativi, economici, culturali) capaci di rendere conveniente contribuire al bene comune. Se davvero la posta in gioco è quale uso prevarrà – un’intelligenza artificiale che chiude i processi, sostituendo i passaggi umani, o una che ne dischiude di inediti, restando strumento nelle mani di chi la impiega -, allora la domanda che si sente ripetere con più insistenza andrebbe capovolta: non «quanti posti di lavoro ci toglierà l’intelligenza artificiale», ma «quale spazio sapremo riservare agli esseri umani dentro questa trasformazione».
Chi ricorda l’avvento di internet (1991) ricorderà anche le profezie di rovina che lo accompagnarono: interi settori pronti a scomparire, milioni di impieghi resi superflui dalla rete. Poco più di un decennio dopo, l’arrivo degli smartphone parve minacciare intere categorie di intermediari, e in parte lo fece. Eppure, in entrambi i casi, attorno a ciascun compito, reso più efficiente dalla macchina, sono germogliate attività. Come il lavoro di chi oggi gestisce i contenuti social di un’azien-da, o di chi progetta i siti web.
Con l’intelligenza artificiale generativa sta accadendo qualcosa di analogo: il World economic forum stima che, oltre il sessanta per cento delle professioni che eserciteremo fra cinque anni, non esista ancora, e che una quota consistente dei bambini oggi seduti nei banchi di scuola svolgerà, da adulto, una professione che nessuno ha ancora inventato. Alcune di queste professioni sono già in essere: chi addestra i modelli linguistici a comportarsi in modo utile e sicuro, chi ne valuta le implicazioni etiche prima che vengano rilasciati, chi progetta le istruzioni capaci di ottenere da una macchina generativa un risultato davvero pertinente. Si tratta di professioni nate dall’intelligenza artificiale, non malgrado essa. Nulla di tutto questo, tuttavia, accade da sé.
Quando l’intelligenza artificiale viene impiegata unicamente come protesi il risultato non è soltanto un impoverimento dei dati, come si è visto, ma un impoverimento del lavoro stesso: si eliminano i passaggi in cui qualcuno avrebbe potuto imparare, correggere, aggiungere. Quando, invece, viene impiegata come strumento di esplorazione, l’intelligenza artificiale ha bisogno degli esseri umani per funzionare davvero: qualcuno che formuli le domande giuste, che ne verifichi le risposte, che porti nel sistema un’esperienza che da solo non possiede. Non è una sfumatura: è la differenza tra una tecnologia che rende superfluo il lavoro e una che lo trasforma.
Passare dal livello delle decisioni individuali a quello delle scelte politiche significa governare l’intelligenza artificiale. La cosiddetta «governance», però, non esiste al singolare: esistono, fianco a fianco e spesso in conflitto, diverse governance, ciascuna scritta da attori – politici ed economici -, che rispondono a interessi propri.
Gli Stati Uniti hanno scommesso sulla velocità dell’IA. Sul fronte interno la filosofia è quella di imporre pochi vincoli sulle aziende e di lasciare su base volontaria i controlli di sicurezza sui modelli più potenti. A certificare che un modello sia sicuro restano, in ultima istanza, le stesse aziende che lo costruiscono e lo vendono. Sul fronte esterno, tuttavia, soprattutto verso la Cina, la stessa amministrazione si muove con un’aggressività che ha poco a che fare con il libero mercato: vieta l’esportazione dei chip più avanzati e inserisce sempre più aziende cinesi (erano 188 a fine giugno) nella lista nera che blocca l’accesso alla tecnologia americana. La regolazione è tutta spostata sul fronte geopolitico, mentre sul fronte interno, quello degli utilizzi e degli abusi dell’intelligenza artificiale, si lascia fare al mercato.
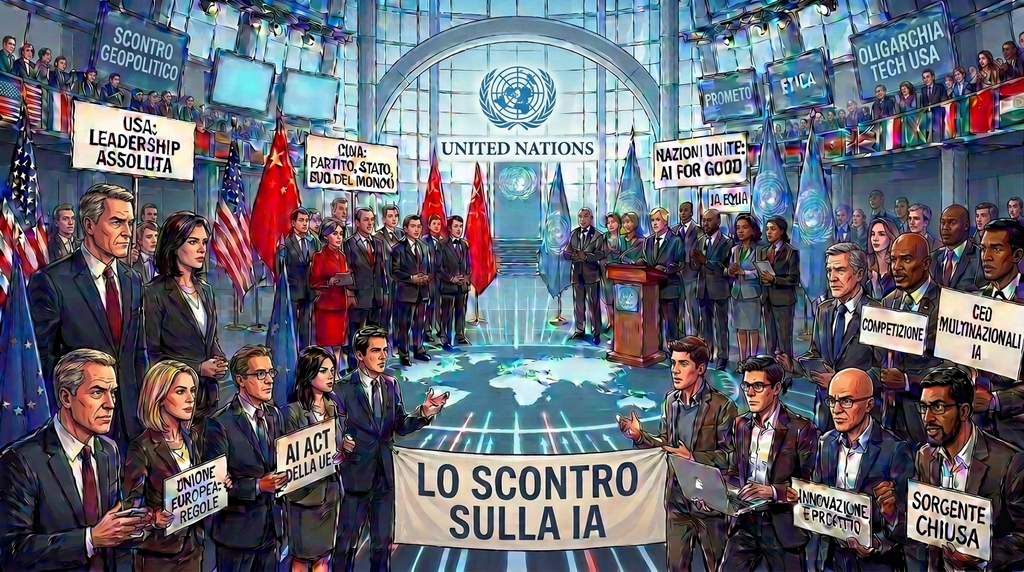
L’Europa ha scommesso sul versante opposto: non la velocità, ma i diritti trasformati in legge. L’AI Act del 2024 classifica i sistemi per livello di rischio, impone documentazione, trasparenza sui dati di addestramento, verifiche indipendenti per i modelli più potenti. Si tratta, però, di una sovranità che si esercita solo sulla carta delle regole, non sull’infrastruttura che quelle regole vorrebbero orientare: l’Europa non possiede i grandi modelli, non possiede i centri di calcolo, non possiede le piattaforme. Può porre condizioni d’accesso al proprio mercato, non indirizzare a monte come l’intelligenza artificiale debba essere concepita: un potere di veto, non un potere di indirizzo. Verrebbe da pensare che la soluzione stia più in alto, in un arbitro super partes come le Nazioni Unite. Qualcosa di concreto, in effetti, è stato costruito: AI for Good, la piattaforma Onu che negli anni ha riunito oltre quattrocento progetti di intelligenza artificiale su obiettivi di sviluppo sostenibile – dalla previsione delle crisi alimentari al monitoraggio dell’acqua – e che ha recentemente dato vita a un forum permanente di dialogo tra governi e a una nuova commissione internazionale sulla governance dell’IA. È un risultato reale, non puramente simbolico, ma AI for Good rimane una piattaforma di dialogo e coordinamento, non un organismo con potere vincolante, paragonabile a quello che l’Agenzia atomica possiede sul tema del nucleare: produce rapporti, buone pratiche, capacità tecnica condivisa, ma non regole corredate da dispositivi di applicazione. E chi siede a quei tavoli, in proporzione rilevante, è la stessa industria tecnologica che quei sistemi produce: le più recenti commissioni Onu sull’IA hanno visto, infatti, gli amministratori delegati dei grandi laboratori partecipare nella veste di membri ufficiali, non di semplici osservatori come accaduto in passato.
Resta il modello della Cina, quello più ambiguo e più difficile da liquidare con un giudizio netto. Da un lato, esso esercita un’attrazione reale, in quanto offre modelli cosiddetti «a pesi aperti» (open weights): si tratta cioè di modelli in cui l’intera struttura numerica che li fa funzionare viene resa pubblica e scaricabile, così che chiunque possa eseguirli sul proprio computer o modificarli, invece di doverli usare solo attraverso un servizio a pagamento. I modelli a pesi aperti, inoltre, vengono offerti insieme a servizi di formazione e infrastrutture a Paesi che non possono permettersi i costi dell’ecosistema occidentale. Si tratta di una sorta di «via della seta digitale», resa istituzionale a metà 2026 con la nascita a Shanghai della World AI cooperation organization (Waico), sottoscritta da trenta Paesi che rappresentano le esigenze del Sud del mondo.
Dall’altro lato, però, lo stesso apparato governativo che rilascia liberamente al mondo intero modelli a pesi aperti impone alle aziende cinesi di sottoporre i propri modelli a verifiche statali di conformità politica: è documentato che i modelli cinesi rifiutino sistematicamente di rispondere su interi capitoli della storia del Paese. Il modello di governance cinese appare, pertanto, funzionale a sostenere un investimento geopolitico: l’apertura verso il Sud del mondo, per quanto concreta, è sempre accompagnata dall’adozione di standard tecnici e di infrastrutture cinesi; i modelli IA hanno un costo estremamente basso, ma manca qualunque contrappeso indipendente capace di verificare, dall’esterno, ciò che davvero viene incorporato in quei modelli.
Velocità senza freni (il modello americano), freni senza infrastruttura (il modello europeo), dialogo senza vincoli (il modello Onu), apertura senza contrappesi (il modello cinese): sono quattro modelli di governance estremamente inadeguati, in quanto concentrano il potere su un solo attore – un’azienda, un regolatore, un forum, uno Stato – non prevedono controlli da parte di istanze indipendenti da coloro che costruiscono i modelli o che li governano politicamente, né riconoscono ai Paesi oggi esclusi un potere reale di partecipazione alla scrittura delle regole. Perché l’intelligenza artificiale possa essere destinata a rimanere un bene comune, piuttosto che l’ennesima risorsa da spartire tra pochi, una autentica governance resta ancora quasi interamente da costruire.
GianMarco Schiesaro
Solo 32 Paesi al mondo ospitano i data center specializzati per l’intelligenza artificiale, e sono due di essi, Stati Uniti e Cina, ne controllano oltre il 90%. L’Africa, dove vive il 18% dell’umanità, pesa per meno dell’1% della capacità di calcolo globale mentre, a settembre 2025, quasi tre quarti della capacità in costruzione nel mondo si concentrava negli Usa1. Prima di chiedersi se l’IA sia «buona» o «cattiva» in assoluto, conviene leggere questi numeri, che raccontano già chi decide, chi produce e chi invece sta soltanto a guardare.
Un’etica «situata» muove da qui. Mentre le grandi dichiarazioni di principio sull’IA, costruite attorno a parole come equità, trasparenza e responsabilità, restano spesso sospese nel vuoto, valide ovunque e perciò in nessun luogo, un’etica situata fa l’opposto: chiede dove la tecnologia poggia i piedi, su quali territori, quali acque, quali lingue, quali corpi. In tale modo la questione etica e quella geopolitica smettono di essere separate.
La geopolitica dell’IA viene di solito raccontata come una gara fra potenze per i microchip e per i modelli più potenti, con i paesi del Golfo (in particolare, Arabia Saudita e Emirati arabi uniti) che lavorano per una «IA sovrana». Sotto quella gara si muove però una redistribuzione silenziosa di costi e benefici, che cadono quasi sempre sulle stesse spalle. Sono effetti in larga parte non ancora regolati, e spesso nemmeno nominati.
L’intelligenza artificiale sembra immateriale, eppure consuma elettricità e acqua in quantità misurabili. Secondo l’Agenzia internazionale dell’energia, nel 2024 i data center hanno assorbito circa 415 TWh (Terawattora, ndr), pari all’1,5% dell’elettricità mondiale. Entro il 2030 la cifra raddoppierà verso i 945 TWh, ovvero quanto consuma oggi l’intero Giappone, e i centri ottimizzati per l’IA cresceranno di oltre quattro volte2.
Per onestà, occorre anche che si dica il resto: in termini aggregati i data center restano una voce contenuta della domanda elettrica, e al 2030 la loro crescita peserà meno di quella dei condizionatori o delle auto elettriche3. Il problema vero sta nella concentrazione: in Irlanda, i data center assorbono già un quinto dell’elettricità nazionale (a Dublino quasi l’80%) e in Virginia un quarto: dove sorgono, riscrivono gli equilibri locali di energia e di acqua.
Sull’acqua le cifre parlano da sole. Uno studio dell’Università della California ha calcolato che addestrare GPT-3 nei data center statunitensi di Microsoft può far evaporare circa 700mila litri di acqua dolce per il solo raffreddamento, oltre 5 milioni contando i consumi indiretti, e che, entro il 2027, i prelievi idrici legati all’IA potrebbero arrivare a una cifra stimata tra 4,2 e 6,6 miliardi di metri cubi l’anno, da 4 a 6 volte il consumo della Danimarca4. Molti impianti sorgono in aree già aride e usano spesso acqua potabile. L’Unione europea ha da poco imposto la rendicontazione dei consumi idrici per i data center sopra i 500 KW, mentre altrove la trasparenza resta assai scarsa.
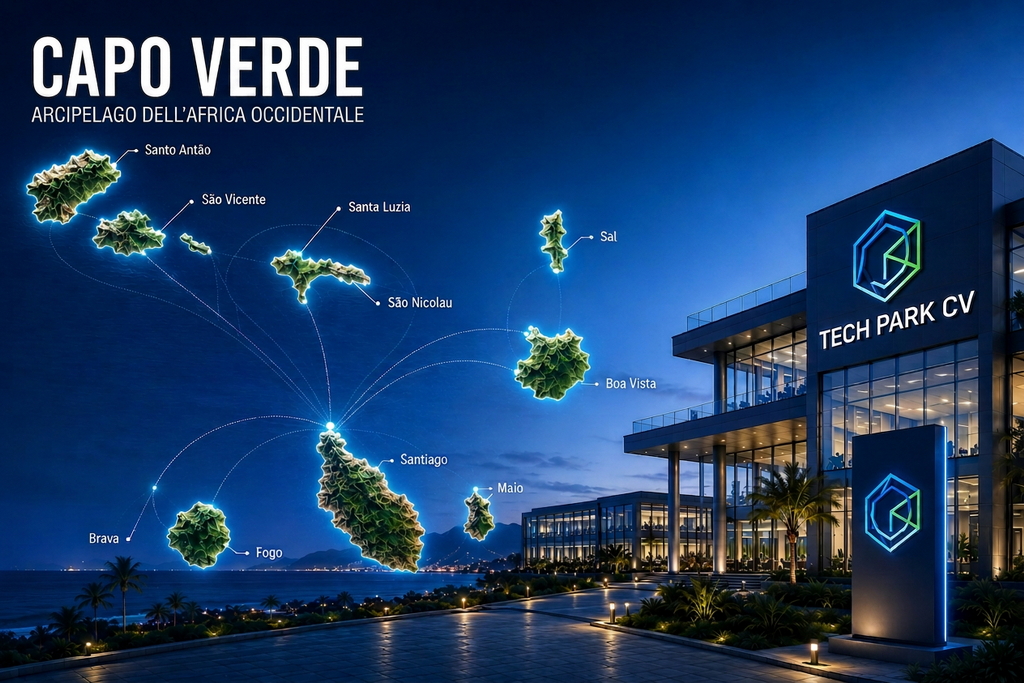
Capo Verde rappresenta un caso esemplare, nonché ambivalente. Nel 2025, l’arcipelago ha inaugurato il «TechPark CV», con un data center sull’isola di Santiago sostenuto da circa 50 milioni di dollari della Banca africana di sviluppo5. Il parco non è un colosso – otto ettari e circa 1.500 posti di lavoro previsti – e proprio la sua misura modesta rende la domanda più seria, perché tocca un’economia assai fragile.
Per il Governo è una scommessa di sovranità digitale e di lavoro per i giovani, una via d’uscita dalla dipendenza dal turismo, ma resta la domanda che si pone di rado: quanta energia e quanta acqua può impegnare un piccolo Stato insulare dove l’acqua dolce già scarseggia? In sostanza, la stessa struttura che promette autonomia potrebbe produrre nuova dipendenza.
Esiste un’asimmetria meno visibile, quella dei dati. Per i grandi modelli linguistici l’Africa è quasi una «zona d’ombra», secondo l’espressione di Katherine Getao, già a capo dell’autorità keniana per le tecnologie dell’informazione: il continente contribuisce con una porzione minima ai dati di addestramento, e ciò che entra arriva spesso da agenzie di sviluppo o Università straniere, non da voci africane6. Si ottengono così sistemi che parlano dell’Africa senza l’Africa, e che funzionano peggio nelle sue lingue7.
L’asimmetria va oltre le parole: un modello addestrato in prevalenza su testi anglofoni porta con sé categorie, gerarchie e modi di vedere il mondo. Quando diventa l’interfaccia ordinaria verso il sapere anche nel Sud globale, tende ad appiattire le epistemologie locali su una misura unica, divenendo così strumento di nuova colonizzazione, fatta di default e di suggerimenti.
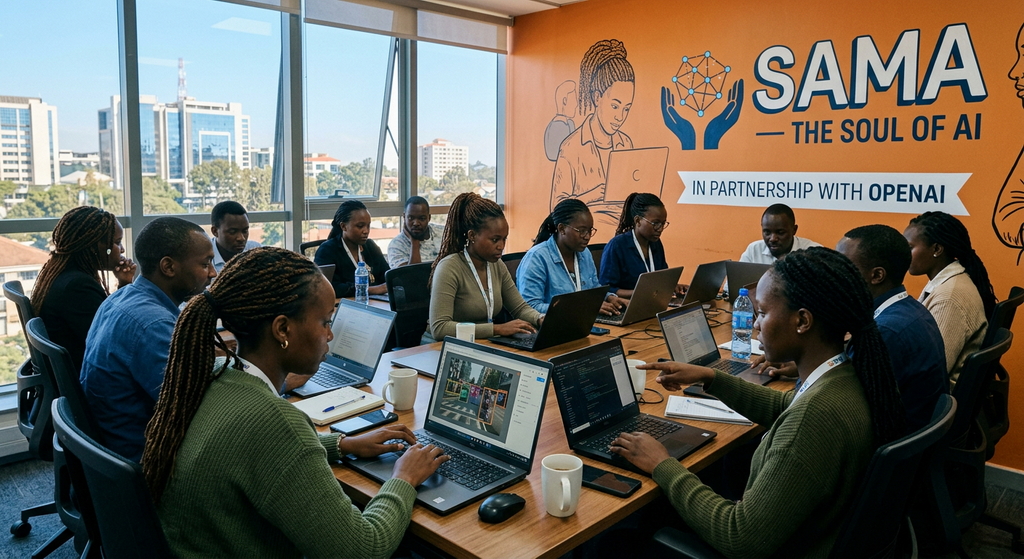
L’esclusione ha anche un corpo, e quel corpo lavora: per rendere ChatGPT meno tossico, OpenAI si è affidata a lavoratori keniani reclutati tramite Sama, una società di San Francisco (The soul of AI), e pagati meno di 2 dollari l’ora per «etichettare» (labelling) migliaia di testi che descrivevano abusi, violenze e torture. Allo stesso tempo, OpenAI riconosceva a Sama circa 12,50 dollari l’ora per lavoratore (AI annotator, in inglese)8. Questo significa che il valore prodotto a Nairobi è migrato verso la California, mentre sfruttamento e traumi sono rimasti nella metropoli keniana.
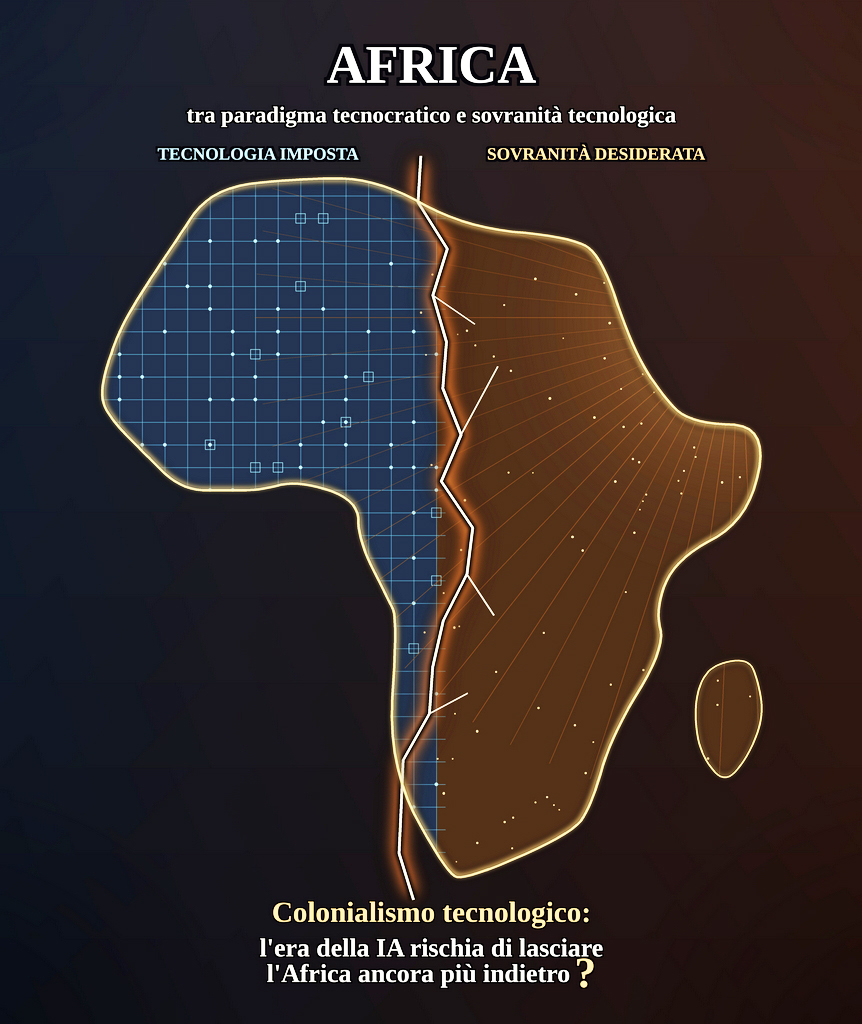
C’è chi parla apertamente di «colonialismo dei dati», indicando una materia prima estratta a Sud con il suo controvalore che risale a Nord. Lo stesso presidente di Microsoft, Brad Smith, ha riconosciuto che «l’era dell’IA rischia di lasciare l’Africa ancora più indietro9».
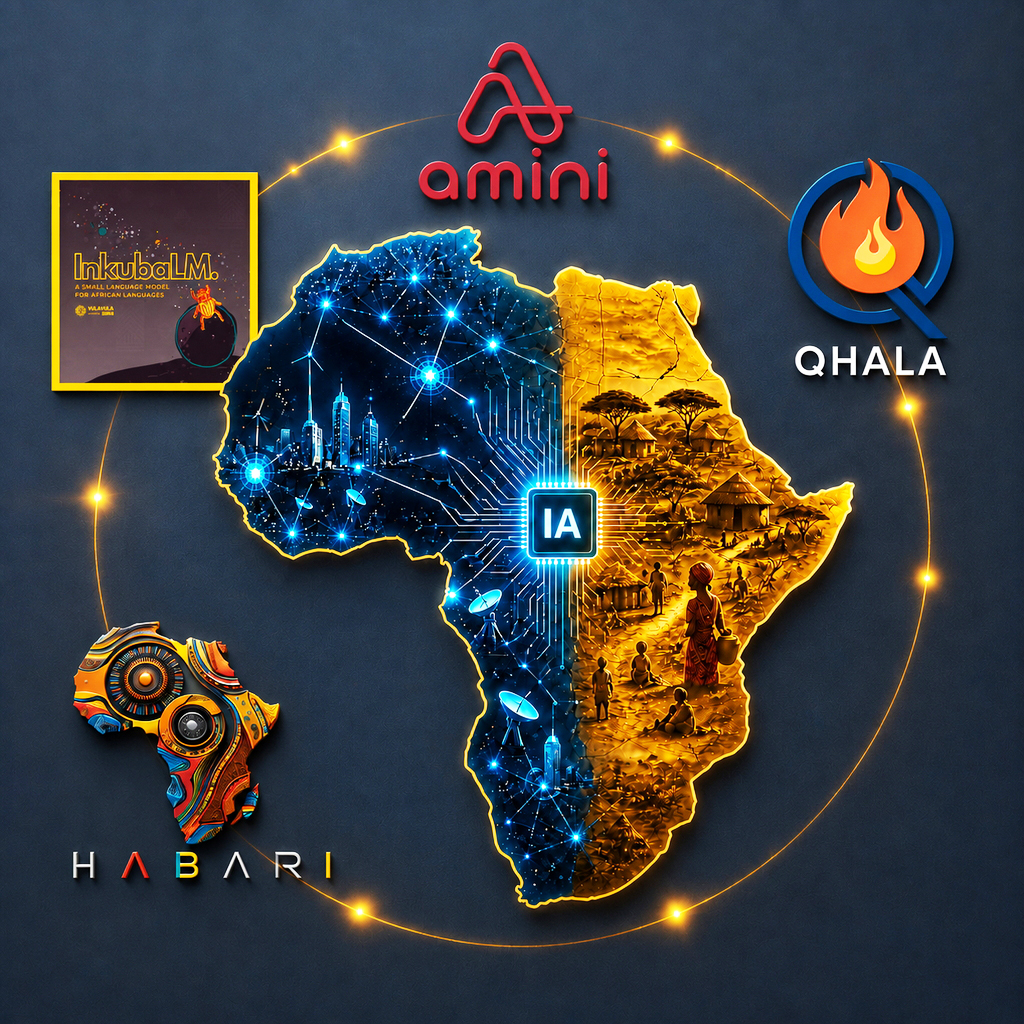
Sarebbe ingiusto, però, ridurre l’Africa a mera vittima. Nel continente cresce una risposta, attraverso modelli linguistici «piccoli» come InkubaLM, addestrato su swahili, yoruba, isiXhosa, hausa e isiZulu – lingue parlate da oltre 350 milioni di persone – e startup come Qhala e Amini, che rivendicano dati e calcolo propri. Eppure, stima l’Undp, solo il 5% dei ricercatori africani di IA dispone della potenza di calcolo che gli serve, e nessuno dei principali super computer del mondo si trova in Africa. La sovranità tecnologica diviene, pertanto, una questione di giustizia, prima che di mercato10.
A questo punto, l’etica «situata» incontra la dottrina sociale della Chiesa. Il 15 maggio 2026, nel 135° anniversario della Rerum Novarum, Leo XIV ha firmato la sua prima enciclica, Magnifica humanitas, dedicata alla salvaguardia della persona umana nel tempo dell’Intelligenza artificiale11.
Il Papa colloca l’IA tra le res novae del presente, una nuova questione sociale, e la giudica alla luce del «paradigma tecnocratico» già denunciato dalla Laudato si’ di Francesco. Ribadisce, quindi, il primato del lavoro sulla finanza, parla di nuove forme di schiavitù da spezzare, chiede di guardare la tecnica dalla parte delle vittime e di costruire un’ecologia della comunicazione.
L’immagine d’apertura del testo è netta: l’umanità può innalzare una nuova torre di Babele oppure costruire «la città in cui Dio e l’uomo abitano insieme». Il tema non è nuovo per il magistero recente: la nota vaticana Antiqua et nova, del gennaio 2025, aveva già messo in guardia dal confondere l’intelligenza delle macchine con quella umana e Francesco, primo Papa a parlare a un G7 nel 2024, aveva posto la questione del controllo umano sugli algoritmi12.
In questa storia, le vittime hanno volti precisi: etichettatore di Nairobi chino su immagini di abuso, l’isola atlantica che cede la sua acqua dolce al raffreddamento dei server, la lingua che nessun modello sa ancora ascoltare. Un’etica situata per la geopolitica dell’IA non domanda anzitutto se la macchina sia buona: domanda, piuttosto, a chi giova, chi ne paga il prezzo in energia, acqua e lavoro, in quale lingua pensa, quali popoli rende invisibili. Sono domande di giustizia e la «missione», da sempre, comincia esattamente da lì.
Paolo Rossi e Marco Dotti
L’intelligenza artificiale rappresenta una delle più radicali trasformazioni del nostro tempo. Essa incide sul modo di lavorare, di apprendere, di comunicare, di prendere decisioni e, in prospettiva, persino sul modo in cui l’essere umano comprende se stesso. Per questo motivo, la Chiesa non può limitarsi a osservare il fenomeno dall’esterno, né tantomeno assumere un atteggiamento di semplice diffidenza o di ingenuo entusiasmo. Essa si propone di offrire un discernimento che aiuti a comprendere quale uso dell’intelligenza artificiale sia realmente conforme alla dignità della persona e al bene comune.
La tradizione sociale della Chiesa ha sempre accolto con favore il progresso scientifico quando esso si pone al servizio della persona. La tecnica, infatti, è una manifestazione dell’intelligenza umana. Essa non è, di per sé, né buona né cattiva. Acquista una precisa connotazione etica nel momento in cui viene orientata verso determinati fini. Quello che assume rilevanza, quindi, non è se sviluppare o meno l’intelligenza artificiale, ma quale idea di persona debba guidarne lo sviluppo.
È questo il cuore del magistero proposto, all’inizio del suo pontificato, da Leone XIV.
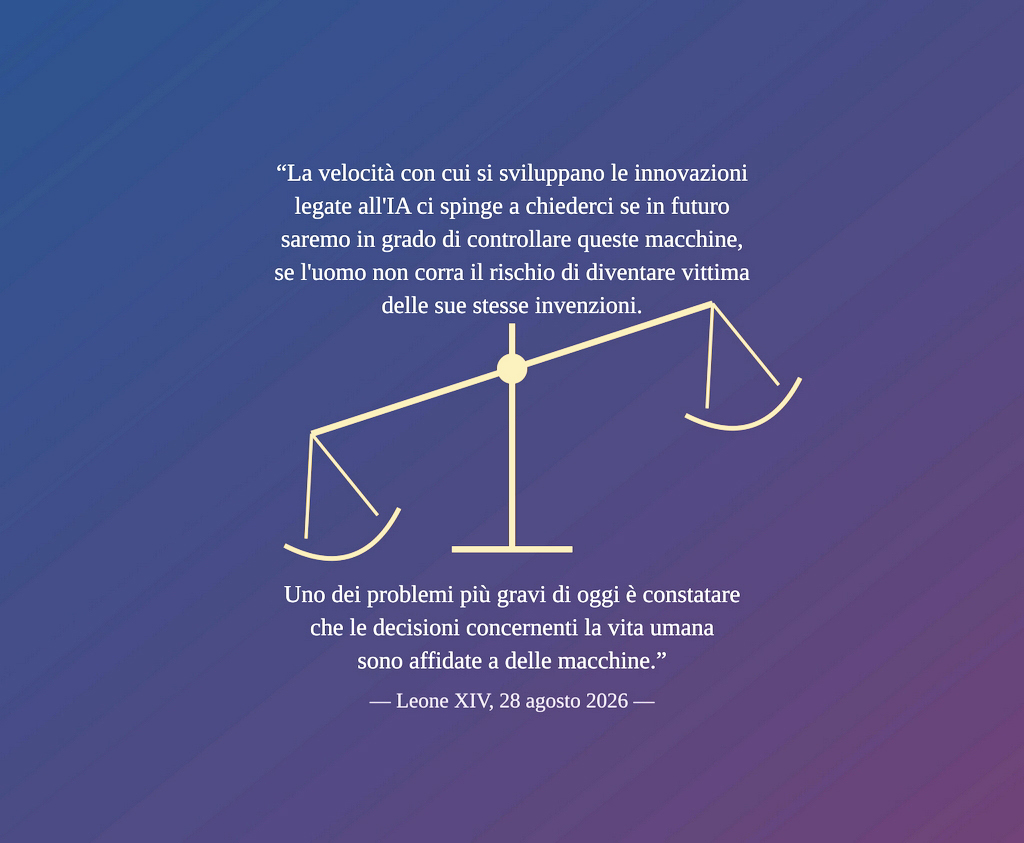
Nell’enciclica Magnifica humanitas, il Papa invita a considerare le nuove tecnologie come strumenti che devono essere continuamente ricondotti alla loro originaria vocazione: promuovere la persona favorendo le relazioni autentiche, sostenere il lavoro umano e rafforzare la solidarietà tra i popoli. L’innovazione tecnologica, ricorda il pontefice, non costituisce il fine del progresso; il suo valore dipende dalla capacità di contribuire alla crescita integrale dell’essere umano.
La questione, dunque, non è tecnologica, ma antropologica. Ogni rivoluzione tecnica porta, infatti, con sé una determinata immagine dell’essere umano. Se la persona viene considerata soltanto come un insieme di dati da elaborare o come un soggetto da rendere sempre più efficiente, allora anche l’intelligenza artificiale finirà inevitabilmente per essere orientata secondo criteri di produttività e controllo. Se, invece, la persona è riconosciuta nella sua irriducibile dignità e nella sua apertura alla relazione e alla trascendenza, allora la tecnologia potrà diventare uno strumento di promozione umana.
In questo senso, la Chiesa richiama costantemente un principio fondamentale: l’intelligenza artificiale deve rimanere al servizio dell’essere umano e non sostituirsi alla responsabilità morale della persona. Gli algoritmi non possono assumere decisioni che coinvolgano la coscienza e la responsabilità della persona. Nessuna macchina, per quanto sofisticata, possiede quella capacità di discernimento che nasce dalla coscienza e dall’esperienza del bene.
Il tema assume particolare rilevanza nel mondo del lavoro. L’intelligenza artificiale promette significativi incrementi di produttività e apre prospettive straordinarie nei campi della medicina, della ricerca scientifica, dell’istruzione e della tutela dell’ambiente. Al tempo stesso, però, essa rischia di accentuare nuove forme di esclusione sociale, sostituire attività professionali consolidate e ampliare le disuguaglianze tra chi possiede conoscenze e tecnologie e chi, invece, ne rimane escluso. Per la dottrina sociale della Chiesa il lavoro non coincide mai con la sola produzione di ricchezza. Esso è anzitutto luogo di sviluppo personale e di partecipazione alla vita della comunità, avendo come fine quello della costruzione del bene comune. Ogni innovazione che impoverisca questa dimensione umana finirebbe per rappresentare un arretramento della civiltà, anche qualora producesse maggiori benefici economici.
Da questa prospettiva emerge con forza anche il tema della governance dell’intelligenza artificiale. Né il mercato né la sola capacità innovativa delle imprese riescono a presidiare questa variabile. Occorrono istituzioni e norme condivise che, attraverso il coinvolgimento di diversi attori, ognuno con proprie responsabilità, orientino lo sviluppo tecnologico verso finalità autenticamente umane.
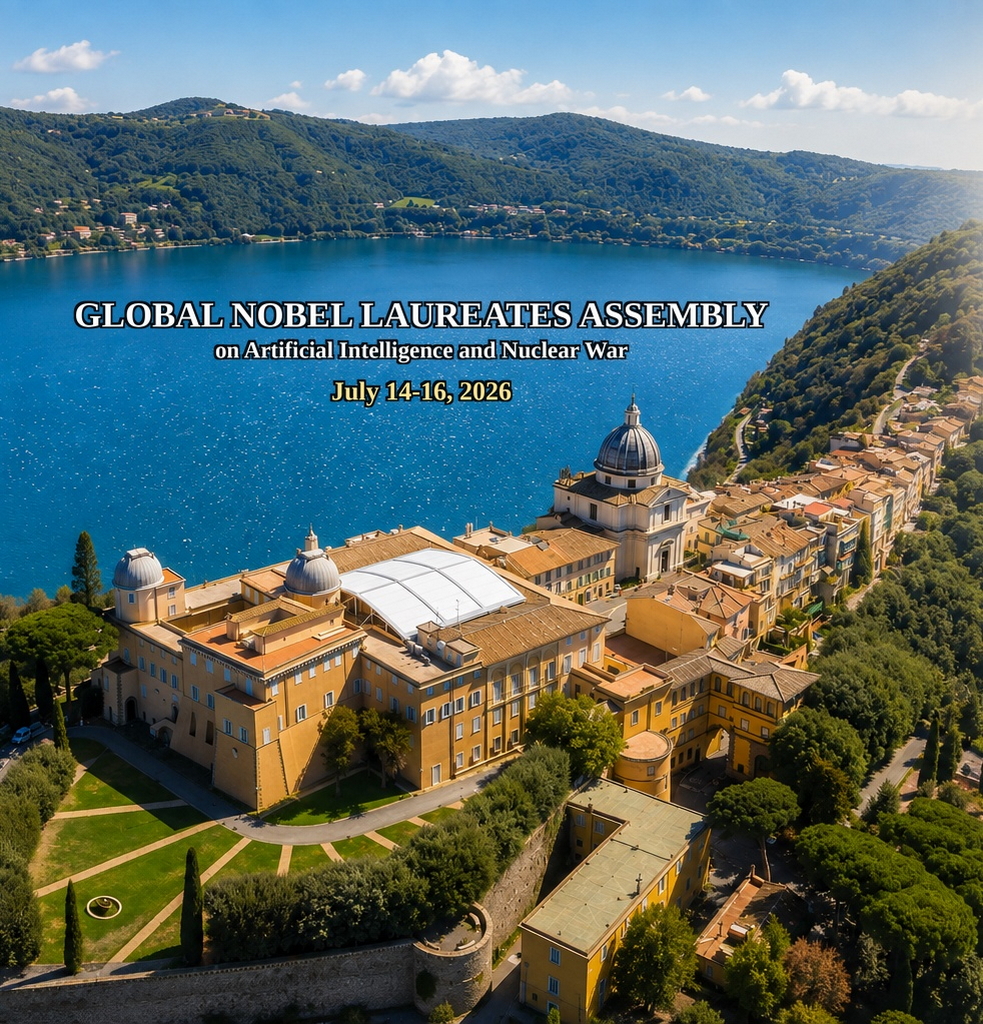
Significativo, a questo proposito, appare il recente convegno internazionale tenutosi a Borgo Laudato si’ presso la residenza papale di Castel Gandolfo e conclusosi il 16 luglio scorso con la sottoscrizione, in Campidoglio, della «Dichiarazione di Roma». Riunendo premi Nobel, scienziati, esperti di intelligenza artificiale, rappresentanti religiosi ed ex responsabili delle istituzioni internazionali, il documento richiama l’urgenza di una governance globale delle tecnologie emergenti.
Tra i principi affermati figurano il mantenimento di un controllo umano effettivo sulle decisioni critiche, il rifiuto di affidare ai sistemi automatizzati la scelta dell’impiego delle armi nucleari, la promozione di uno sviluppo dell’intelligenza artificiale orientato al bene comune, ai diritti umani e alla pace. La Dichiarazione richiama, inoltre, la necessità di costruire un autentico «bene comune digitale» (digital commons), capace di mettere la conoscenza e i dati al servizio dell’intera famiglia umana e non degli interessi di pochi.
Questa prospettiva appare pienamente coerente con l’insegnamento della Magnifica humanitas. La Chiesa non propone un freno all’innovazione, ma un diverso criterio per valutarla. Il vero progresso non coincide con ciò che è semplicemente possibile realizzare; coincide con ciò che rende più umana la vita delle persone. Una società tecnologicamente avanzata, ma incapace di custodire la dignità dei più fragili, non può definirsi realmente sviluppata.
L’intelligenza artificiale pone, in definitiva, una domanda che precede ogni algoritmo: quale idea di persona desideriamo costruire? Se la risposta sarà affidata esclusivamente alla tecnica, il rischio potrà essere quello di misurare tutto secondo criteri di efficienza e prestazione. Se invece continuerà a essere guidata da una visione integrale della persona, allora la tecnologia potrà diventare una straordinaria alleata dello sviluppo umano.
La sfida che la Chiesa consegna al nostro tempo è, dunque, tanto semplice quanto esigente: non chiedere all’essere umano di adattarsi alle macchine, ma progettare le macchine affinché rimangano sempre al servizio della persona. È questa la vera misura dell’innovazione. Non la sua potenza, ma la sua capacità di custodire ciò che rende ogni persona unica, irripetibile e degna di essere sempre posta al centro.
Davide Maggi